正则
正则是匹配模式,要么匹配字符,要么匹配位置。
字符匹配
1.两种模糊匹配
如果我们没有使用模糊匹配,那就是精准匹配,没有太大意义
var regex = /hello/;
console.log(regex.test('hello'));正则表达式之所以强大,是因为能模糊匹配
1.1 横向模糊匹配
横向模糊匹配是指,正则匹配字符串长度不是固定的,可以是多种情况
比如使用量词 {m,n}
var regex = /ab{2,5}c/g;
var string = 'abc abbc abbbc abbbbc abbbbbc abbbbbbc';
console.log(string.match(regex));
// => ["abbc", "abbbc", "abbbbc", "abbbbbc"]1.2 纵向模糊匹配
具体到某一位字符时,可以不是某个确定字符
比如使用字符组[abc]
var regex = /a[123]b/g;
var string = 'a0b a1b a2b a3b a4b';
console.log(string.match(regex));
// => ["a1b", "a2b", "a3b"]2.字符组
2.1 范围表示法
[abc]、[1-6a-fg-m]
2.2 排除表示法
[^abc]非 abc 之中一个
2.3 常见的简写形式
\d 就是[0-9]。表示是一位数字。记忆方式:其英文是 digit(数字)。
\D 就是[^0-9]。表示除数字外的任意字符。
\w 就是[0-9a-zA-Z_]。表示数字、大小写字母和下划线。记忆方式:w 是 word 的简写,也称单词字符。
\W 是[^0-9a-zA-Z_]。非单词字符。
\s 是[ \t\v\n\r\f]。表示空白符,包括空格、水平制表符、垂直制表符、换行符、回车符、换页符。记忆方式:s 是 space character 的首字母。
\S 是[^ \t\v\n\r\f]。 非空白符。
.就是[^\n\r\u2028\u2029]。通配符,表示几乎任意字符。换行符、回车符、行分隔符和段分隔符除外。记忆方式:想想省略号...中的每个点,都可以理解成占位符,表示任何类似的东西。
匹配任意字符
[\d\D]、[\w\W]、[\s\S]和[^]中任何的一个
3.量词
量词也称重复。掌握{m,n}的准确含义后,只需要记住一些简写形式。
3.1 简写形式
{m,} 表示至少出现 m 次。
{m} 等价于{m,m},表示出现 m 次。
? 等价于{0,1},表示出现或者不出现。记忆方式:问号的意思表示,有吗?
- 等价于{1,},表示出现至少一次。记忆方式:加号是追加的意思,得先有一个,然后才考虑追加。
- 等价于{0,},表示出现任意次,有可能不出现。记忆方式:看看天上的星星,可能一颗没有,可能零散有几颗,可能数也数不过来。
3.2 贪婪匹配和惰性匹配
var regex = /\d{2,5}/g;
var string = '123 1234 12345 123456';
console.log(string.match(regex));
// => ["123", "1234", "12345", "12345"]其中正则/\d{2,5}/,表示数字连续出现 2 到 5 次。会匹配 2 位、3 位、4 位、5 位连续数字。
但是其是贪婪的,它会尽可能多的匹配。
var regex = /\d{2,5}?/g;
var string = '123 1234 12345 123456';
console.log(string.match(regex));
// => ["12", "12", "34", "12", "34", "12", "34", "56"]其中/\d{2,5}?/表示,虽然 2 到 5 次都行,当 2 个就够的时候,就不在往下尝试了。
通过在量词后面加个问号就能实现惰性匹配,因此所有惰性匹配情形如下:
{m,n}?
{m,}?
??
+?
*?
4.多选分支
(p1|p2|p3)
分支结构也是惰性的,即当前面的匹配上了,后面的就不再尝试了。
5.示例
5.1 匹配颜色
var regex = /#([0-9a-fA-F]{6}|[0-9a-fA-F]{3})/g;
var string = '#ffbbad #Fc01DF #FFF #ffE';
console.log(string.match(regex));
// => ["#ffbbad", "#Fc01DF", "#FFF", "#ffE"]5.2 匹配时间
var regex = /^([01][0-9]|[2][0-3]):[0-5][0-9]$/;
console.log(regex.test('23:59'));
console.log(regex.test('02:07'));
// => true
// => true5.3 匹配日期
var regex = /^[0-9]{4}-(0[1-9]|1[0-2])-(0[1-9]|[12][0-9]|3[01])$/;
console.log(regex.test('2017-06-10'));
// => true5.4 window 操作系统文件路径
var regex = /^[a-zA-Z]:\\([^\\:*<>|"?\r\n/]+\\)*([^\\:*<>|"?\r\n/]+)?$/;
console.log(
  regex.test('F:\\study\\javascript\\regex\\regular expression.pdf')
);
console.log(regex.test('F:\\study\\javascript\\regex\\'));
console.log(regex.test('F:\\study\\javascript'));
console.log(regex.test('F:\\'));
// => true
// => true
// => true
// => true5.5 匹配 id
var regex = /id=".*?"/;
var string = '<div id="container" class="main"></div>';
console.log(string.match(regex)[0]);
// => id="container"使用?非贪婪匹配,但是性能会比较低,因为设计到回溯,可优化
var regex = /id="[^"]*"/;
var string = '<div id="container" class="main"></div>';
console.log(string.match(regex)[0]);
// => id="container"位置匹配
1.什么是位置呢?
位置是相邻字符之间的位置 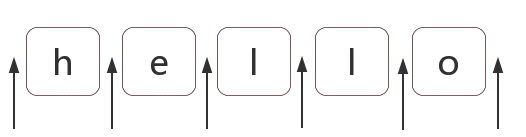
2. 如何匹配位置呢?
在 ES5 中,共有 6 个锚字符:
^ $ \b \B (?=p) (?!p)
^和$
开头和结尾
var result = 'hello'.replace(/^|$/g, '#');
console.log(result);
// => "#hello#"TIP
位置可以替换成字符
多行模式
var result = 'I\nlove\njavascript'.replace(/^|$/gm, '#');
console.log(result);
/*
#I#
#love#
#javascript#
*/2.2 \b 和\B
\b是单词边界,具体就是\w和\W之间的位置,也包括\w和^之间的位置,也包括\w和$之间的位置。
var result = '[JS] Lesson_01.mp4'.replace(/\b/g, '#');
console.log(result);
// => "[#JS#] #Lesson_01#.#mp4#"\B就是\b的反面的意思,非单词边界。例如在字符串中所有位置中,扣掉\b,剩下的都是\B的。
var result = '[JS] Lesson_01.mp4'.replace(/\B/g, '#');
console.log(result);
// => "#[J#S]# L#e#s#s#o#n#_#0#1.m#p#4"2.3 (?=p)和(?!p)
正向先行断言和负向先行断言
(?=p),其中p是一个子模式,即p前面的位置。
var result = 'hello'.replace(/(?=l)/g, '#');
console.log(result);
// => "he#l#lo"而(?!p)就是(?=p)的反面意思
var result = 'hello'.replace(/(?!l)/g, '#');

console.log(result);
// => "#h#ell#o#"TIP
ES6 中,还支持 (?<=p)和(?<!p)
3. 位置的特性
可以理解成空字符""。
比如"hello"字符串等价于如下的形式:
'hello' == '' + 'h' + '' + 'e' + '' + 'l' + '' + 'l' + 'o' + '';也等价于:
'hello' == '' + '' + 'hello';因此,把/^hello$/写成/^^hello?$/,是没有任何问题的:
var result = /^^hello?$/.test('hello');
console.log(result);
// => true甚至可以写成更复杂的:
var result = /(?=he)^^he(?=\w)llo$\b\b$/.test('hello');
console.log(result);
// => true4. 相关案例
4.1 不匹配任何东西的正则
/.^/; 因为此正则要求只有一个字符,但该字符后面是开头。
4.2 数字的千位分隔符表示法
4.2.1 弄出最后一个逗号
var result = '12345678'.replace(/(?=\d{3}$)/g, ',');
console.log(result);
// => "12345,678"4.2.2 弄出所有的逗号
var result = '123456789'.replace(/(?=(\d{3})+$)/g, ',');
console.log(result);
// => ",123,456,789"4.2.3 匹配其余案例
我们要求匹配的到这个位置不能是开头。
var string1 = '12345678',
  string2 = '123456789';
reg = /(?!^)(?=(\d{3})+$)/g;

var result = string1.replace(reg, ',');
console.log(result);
// => "12,345,678"

result = string2.replace(reg, ',');
console.log(result);
// => "123,456,789"4.2.4 支持其他形式
var string = '12345678 123456789',
  reg = /(?!\b)(?=(\d{3})+\b)/g; // /\B(?=(\d{3})+\b)/g

var result = string.replace(reg, ',');
console.log(result);
// => "12,345,678 123,456,789"4.3 验证密码问题
密码长度 6-12 位,由数字、小写字符和大写字母组成,但必须至少包括 2 种字符。
至少包括 2 种字符
var reg = /^[0-9A-Za-z]{6,12}$/;判断是否包含有某一种字符 ;假设,要求的必须包含数字 (?=.*[0-9])
var reg = /(?=.*[0-9])^[0-9A-Za-z]{6,12}$/;同时包含具体两种字符
var reg = /(?=.*[0-9])(?=.*[a-z])^[0-9A-Za-z]{6,12}$/;最终结果是
var reg =
  /((?=.*[0-9])(?=.*[a-z])|(?=.*[0-9])(?=.*[A-Z])|(?=.*[a-z])(?=.*[A-Z]))^[0-9A-Za-z]{6,12}$/;
console.log(reg.test('1234567')); // false 全是数字
console.log(reg.test('abcdef')); // false 全是小写字母
console.log(reg.test('ABCDEFGH')); // false 全是大写字母
console.log(reg.test('ab23C')); // false 不足6位
console.log(reg.test('ABCDEF234')); // true 大写字母和数字
console.log(reg.test('abcdEF234')); // true 三者都有另外一种解法
不能全部都是数字,也不能全部都是小写字母,也不能全部都是大写字母
var reg =
  /(?!^[0-9]{6,12}$)(?!^[a-z]{6,12}$)(?!^[A-Z]{6,12}$)^[0-9A-Za-z]{6,12}$/;
console.log(reg.test('1234567')); // false 全是数字
console.log(reg.test('abcdef')); // false 全是小写字母
console.log(reg.test('ABCDEFGH')); // false 全是大写字母
console.log(reg.test('ab23C')); // false 不足6位
console.log(reg.test('ABCDEF234')); // true 大写字母和数字
console.log(reg.test('abcdEF234')); // true 三者都有括号的作用
括号提供了分组,便于我们引用它
1.分组和分支结构
/a+/匹配连续出现的“a”,而要匹配连续出现的“ab”时,需要使用/(ab)+/
而在多选分支结构(p1|p2)中,提供了子表达式的所有可能。
2. 引用分组
可以进行数据提取,以及更强大的替换操作
2.1 提取数据
比如提取出年、月、日,可以这么做:
var regex = /(\d{4})-(\d{2})-(\d{2})/;
var string = '2017-06-12';
console.log(string.match(regex));
// => ["2017-06-12", "2017", "06", "12", index: 0, input: "2017-06-12"]match返回的一个数组,第一个元素是整体匹配结果,然后是各个分组(括号里)匹配的内容,然后是匹配下标,最后是输入的文本。(注意:如果正则是否有修饰符g,match返回的数组格式是不一样的)
另外也可以使用正则对象的exec方法:
var regex = /(\d{4})-(\d{2})-(\d{2})/;
var string = '2017-06-12';
console.log(regex.exec(string));
// => ["2017-06-12", "2017", "06", "12", index: 0, input: "2017-06-12"]同时,也可以使用构造函数的全局属性$1至$9来获取:
var regex = /(\d{4})-(\d{2})-(\d{2})/;
var string = '2017-06-12';

regex.test(string); // 正则操作即可,例如
//regex.exec(string);
//string.match(regex);

console.log(RegExp.$1); // "2017"
console.log(RegExp.$2); // "06"
console.log(RegExp.$3); // "12"2.2 替换
var regex = /(\d{4})-(\d{2})-(\d{2})/;
var string = '2017-06-12';
var result = string.replace(regex, '$2/$3/$1');
console.log(result);
// => "06/12/2017"等价于如下的形式:
var regex = /(\d{4})-(\d{2})-(\d{2})/;
var string = '2017-06-12';
var result = string.replace(regex, function () {
  return RegExp.$2 + '/' + RegExp.$3 + '/' + RegExp.$1;
});
console.log(result);
// => "06/12/2017"也等价于:
var regex = /(\d{4})-(\d{2})-(\d{2})/;
var string = '2017-06-12';
var result = string.replace(regex, function (match, year, month, day) {
  return month + '/' + day + '/' + year;
});
console.log(result);
// => "06/12/2017"3. 反向引用
比如要写一个正则支持匹配如下三种格式:
2016-06-12

2016/06/12

2016.06.12最先可能想到的正则是:
var regex = /\d{4}(-|\/|\.)\d{2}(-|\/|\.)\d{2}/;
var string1 = '2017-06-12';
var string2 = '2017/06/12';
var string3 = '2017.06.12';
var string4 = '2016-06/12';
console.log(regex.test(string1)); // true
console.log(regex.test(string2)); // true
console.log(regex.test(string3)); // true
console.log(regex.test(string4)); // true虽然匹配了要求的情况,但也匹配"2016-06/12"这样的数据。
假设我们想要求分割符前后一致怎么办?此时需要使用反向引用:
var regex = /\d{4}(-|\/|\.)\d{2}\1\d{2}/;
var string1 = '2017-06-12';
var string2 = '2017/06/12';
var string3 = '2017.06.12';
var string4 = '2016-06/12';
console.log(regex.test(string1)); // true
console.log(regex.test(string2)); // true
console.log(regex.test(string3)); // true
console.log(regex.test(string4)); // false注意里面的\1,表示的引用之前的那个分组(-|\/|\.)。不管它匹配到什么(比如-),\1都匹配那个同样的具体某个字符。
我们知道了\1的含义后,那么\2和\3的概念也就理解了,即分别指代第二个和第三个分组。
3.1 括号嵌套怎么办?
var regex = /^((\d)(\d(\d)))\1\2\3\4$/;
var string = '1231231233';
console.log(regex.test(string)); // true
console.log(RegExp.$1); // 123
console.log(RegExp.$2); // 1
console.log(RegExp.$3); // 23
console.log(RegExp.$4); // 3- 第一个字符是数字,比如说 1,
- 第二个字符是数字,比如说 2,
- 第三个字符是数字,比如说 3,
- 接下来的是\1,是第一个分组内容,那么看第一个开括号对应的分组是什么,是 123,
- 接下来的是\2,找到第 2 个开括号,对应的分组,匹配的内容是 1,
- 接下来的是\3,找到第 3 个开括号,对应的分组,匹配的内容是 23,
- 最后的是\4,找到第 4 个开括号,对应的分组,匹配的内容是 3。
3.2 \10 表示什么呢?
\10是表示第10个分组,还是\1和0呢?
var regex = /(1)(2)(3)(4)(5)(6)(7)(8)(9)(#) \10+/;
var string = '123456789# ######';
console.log(regex.test(string));
// => true3.3 引用不存在的分组
此时正则不会报错,只是匹配反向引用的字符本身。例如\2,就匹配"\2"。注意"\2"表示对"2"进行了转意。
var regex = /\1\2\3\4\5\6\7\8\9/;
console.log(regex.test('\1\2\3\4\5\6\789'));
console.log('\1\2\3\4\5\6\789'.split(''));4. 非捕获分组
如果只想要括号最原始的功能,但不会引用它,即,既不在 API 里引用,也不在正则里反向引用。此时可以使用非捕获分组(?:p)
5. 相关案例
5.1 字符串 trim 方法模拟
第一种,匹配到开头和结尾的空白符,然后替换成空字符。
function trim(str) {
  return str.replace(/^\s+|\s+$/g, '');
}
console.log(trim('  foobar   '));
// => "foobar"第二种,匹配整个字符串,然后用引用来提取出相应的数据
function trim(str) {
  return str.replace(/^\s*(.*?)\s*$/g, '$1');
}
console.log(trim('  foobar   '));
// => "foobar"这里使用了惰性匹配*?,不然也会匹配最后一个空格之前的所有空格的。
5.2 将每个单词的首字母转换为大写
function titleize(str) {
  return str.toLowerCase().replace(/(?:^|\s)\w/g, function (c) {
    return c.toUpperCase();
  });
}
console.log(titleize('my name is epeli'));
// => "My Name Is Epeli"(?:^|\s): 这是一个非捕获性分组,用于匹配单词字符前面的边界。^匹配字符串的开始,\s匹配空白字符(例如空格、制表符等)。这样,正则表达式可以匹配单词字符的开头,或者单词字符前面紧邻的空白字符
5.3 驼峰化
function camelize(str) {
  return str.replace(/[-_\s]+(.)?/g, function (match, c) {
    return c ? c.toUpperCase() : '';
  });
}
console.log(camelize('-moz-transform'));
// => "MozTransform"其中分组(.)表示首字母。单词的界定是,前面的字符可以是多个连字符、下划线以及空白符。正则后面的?的目的,是为了应对 str 尾部的字符可能不是单词字符,比如 str 是'-moz-transform '。
5.4 中划线化
function dasherize(str) {
  return str
    .replace(/([A-Z])/g, '-$1')
    .replace(/[-_\s]+/g, '-')
    .toLowerCase();
}
console.log(dasherize('MozTransform'));
// => "-moz-transform"5.5 html 转义和反转义
// 将HTML特殊字符转换成等值的实体
function escapeHTML(str) {
var escapeChars = {
'¢': 'cent',
'£': 'pound',
'¥': 'yen',
'€': 'euro',
'©': 'copy',
'®': 'reg',
'<': 'lt',
'>': 'gt',
'"': 'quot',
'&': 'amp',
"'": '#39'
};
return str.replace(
new RegExp('[' + Object.keys(escapeChars).join('') + ']', 'g'),
function (match) {
return '&' + escapeChars[match] + ';';
}
);
}
console.log(escapeHTML('<div>Blah blah blah</div>'));
// => "<div>Blah blah blah</div>";// 实体字符转换为等值的HTML。
function unescapeHTML(str) {
var htmlEntities = {
nbsp: ' ',
cent: '¢',
pound: '£',
yen: '¥',
euro: '€',
copy: '©',
reg: '®',
lt: '<',
gt: '>',
quot: '"',
amp: '&',
apos: "'"
};
return str.replace(/\&([^;]+);/g, function (match, key) {
if (key in htmlEntities) {
return htmlEntities[key];
}
return match;
});
}
console.log(unescapeHTML('<div>Blah blah blah</div>'));
// => "<div>Blah blah blah</div>"5.6 匹配成对标签
匹配一个开标签,可以使用正则<[^>]+>,
匹配一个闭标签,可以使用</[^>]+>,
但是要求匹配成对标签,那就需要使用反向引用,如:
var regex = /<([^>]+)>[\d\D]*<\/\1>/;
var string1 = '<title>regular expression</title>';
var string2 = '<p>laoyao bye bye</p>';
var string3 = '<title>wrong!</p>';
console.log(regex.test(string1)); // true
console.log(regex.test(string2)); // true
console.log(regex.test(string3)); // false正则表达式回溯法原理
1. 没有回溯的匹配
假设我们的正则是/ab{1,3}c/,其可视化形式是:
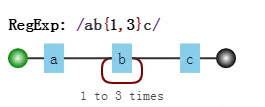
而当目标字符串是"abbbc"时,就没有所谓的“回溯”。其匹配过程是:
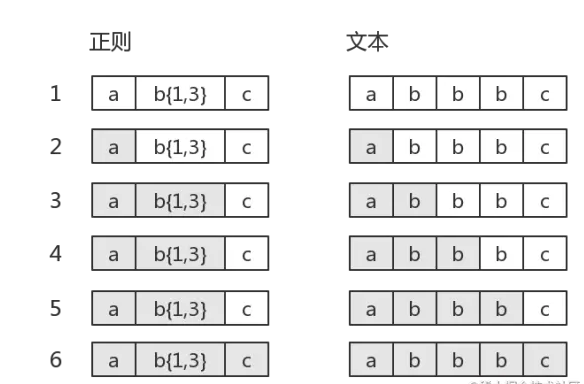
2. 有回溯的匹配
如果目标字符串是"abbc",中间就有回溯。
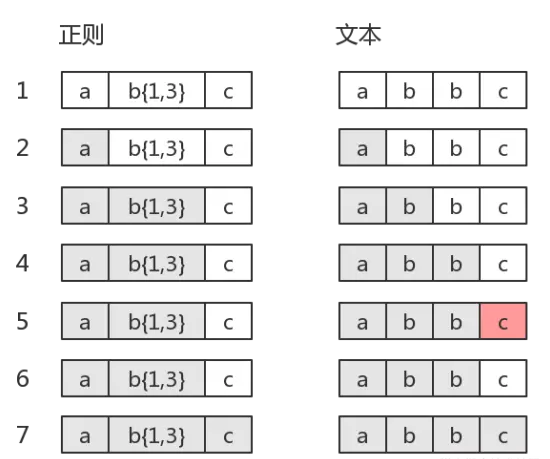
图中第 5 步有红颜色,表示匹配不成功。此时
b{1,3}已经匹配到了 2 个字符“b”,准备尝试第三个时,结果发现接下来的字符是“c”。那么就认为b{1,3}就已经匹配完毕。然后状态又回到之前的状态(即第 6 步,与第 4 步一样),最后再用子表达式 c,去匹配字符“c”。当然,此时整个表达式匹配成功了。
图中的第 6 步,就是“回溯”。
再举一个例子。正则是:
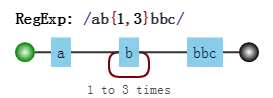
目标字符串是"abbbc",匹配过程是:
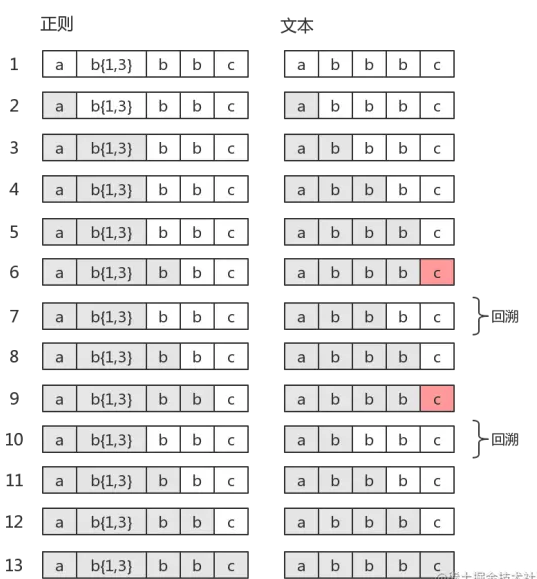
其中第 7 步和第 10 步是回溯。第 7 步与第 4 步一样,此时 b{1,3}匹配了两个"b",而第 10 步与第 3 步一样,此时 b{1,3}只匹配了一个"b",这也是 b{1,3}的最终匹配结果。
再看一个清晰的回溯,正则是:
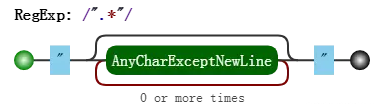
目标字符串是:"acd"ef,匹配过程是:
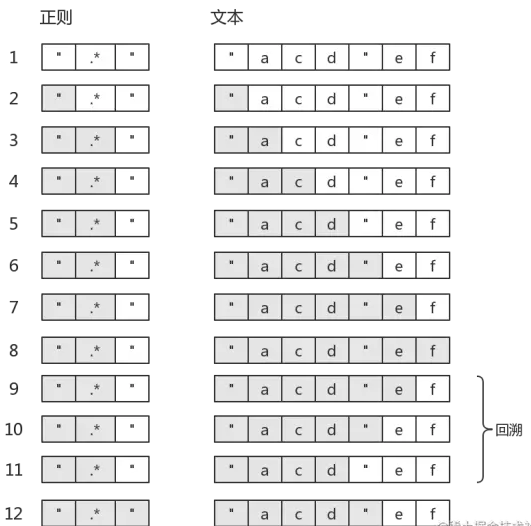
可以看出.*是非常影响效率的。为了减少一些不必要的回溯,可以把正则修改为/"[^"]*"/。
3. 常见的回溯形式
回溯法也称试探法,它的基本思想是:从问题的某一种状态(初始状态)出发,搜索从这种状态出发所能达到的所有“状态”,当一条路走到“尽头”的时候(不能再前进),再后退一步或若干步,从另一种可能“状态”出发,继续搜索,直到所有的“路径”(状态)都试探过。这种不断“前进”、不断“回溯”寻找解的方法,就称作“回溯法”。
本质上就是深度优先搜索算法。其中退到之前的某一步这一过程,我们称为“回溯”。从上面的描述过程中,可以看出,路走不通时,就会发生“回溯”。即,尝试匹配失败时,接下来的一步通常就是回溯。
JS 中正则表达式会产生回溯的地方都有哪些呢?
3.1 贪婪量词
之前的例子都是贪婪量词相关的。比如b{1,3},因为其是贪婪的,尝试可能的顺序是从多往少的方向去尝试。首先会尝试"bbb",然后再看整个正则是否能匹配。不能匹配时,吐出一个"b",即在"bb"的基础上,再继续尝试。如果还不行,再吐出一个,再试。如果还不行呢?只能说明匹配失败了。
如果当多个贪婪量词挨着存在,并相互有冲突时,此时会是怎样?
答案是,先下手为强!因为深度优先搜索。测试如下:
var string = '12345';
var regex = /(\d{1,3})(\d{1,3})/;
console.log(string.match(regex));
// => ["12345", "123", "45", index: 0, input: "12345"]3.2 惰性量词
惰性量词就是在贪婪量词后面加个问号。表示尽可能少的匹配,比如:
var string = '12345';
var regex = /(\d{1,3}?)(\d{1,3})/;
console.log(string.match(regex));
// => ["1234", "1", "234", index: 0, input: "12345"]其中\d{1,3}?只匹配到一个字符"1",而后面的\d{1,3}匹配了"234"。
虽然惰性量词不贪,但也会有回溯的现象。比如正则是:
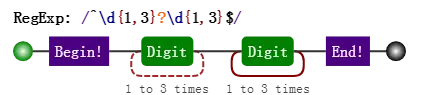
目标字符串是"12345",匹配过程是:
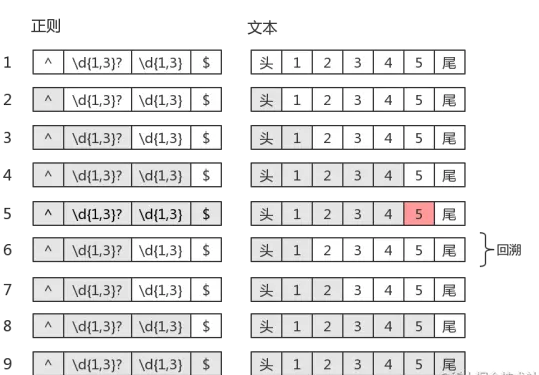
知道你不贪、很知足,但是为了整体匹配成,没办法,也只能给你多塞点了。因此最后\d{1,3}?匹配的字符是"12",是两个数字,而不是一个。
3.3 分支结构
我们知道分支也是惰性的,比如/can|candy/,去匹配字符串"candy",得到的结果是"can",因为分支会一个一个尝试,如果前面的满足了,后面就不会再试验了。
分支结构,可能前面的子模式会形成了局部匹配,如果接下来表达式整体不匹配时,仍会继续尝试剩下的分支。这种尝试也可以看成一种回溯。
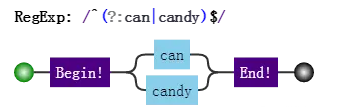
目标字符串是"candy",匹配过程:
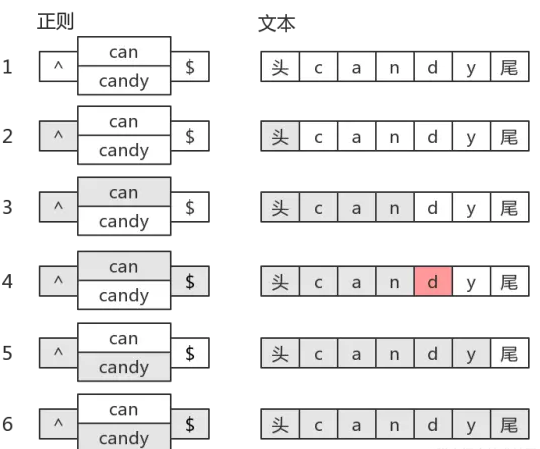
上面第 5 步,虽然没有回到之前的状态,但仍然回到了分支结构,尝试下一种可能。所以,可以认为它是一种回溯的。
小结
- 贪婪量词“试”的策略是:买衣服砍价。价钱太高了,便宜点,不行,再便宜点。
- 惰性量词“试”的策略是:卖东西加价。给少了,再多给点行不,还有点少啊,再给点。
- 分支结构“试”的策略是:货比三家。这家不行,换一家吧,还不行,再换。
而 JS 的正则引擎是 NFA,NFA 是“非确定型有限自动机”的简写。
正则表达式的拆分
1. 结构和操作符
在正则表达式中,操作符都体现在结构中,即由特殊字符和普通字符所代表的一个个特殊整体。
字符字面量、字符组、量词、锚字符、分组、选择分支、反向引用。
- 字面量: 匹配一个具体字符,包括不用转义的和需要转义的。比如 a 匹配字符"a",又比如
\n匹配换行符,又比如\.匹配小数点。 - 字符组: 匹配一个字符,可以是多种可能之一,比如
[0-9],表示匹配一个数字。也有\d的简写形式。另外还有反义字符组,表示可以是除了特定字符之外任何一个字符,比如[^0-9],表示一个非数字字符,也有\D的简写形式。 - 量词: 表示一个字符连续出现,比如
a{1,3}表示“a”字符连续出现 3 次。另外还有常见的简写形式,比如a+表示“a”字符连续出现至少一次。 - 锚点: 匹配一个位置,而不是字符。比如
^匹配字符串的开头,又比如\b匹配单词边界,又比如(?=\d)表示数字前面的位置。 - 分组: 用括号表示一个整体,比如
(ab)+,表示"ab"两个字符连续出现多次,也可以使用非捕获分组(?:ab)+ - 分支: 多个子表达式多选一,比如
abc|bcd,表达式匹配"abc"或者"bcd"字符子串。 - 反向引用: 比如
\2,表示引用第 2 个分组。
其中涉及到的操作符有:
- 1.转义符
\ - 2.括号和方括号
(...)、(?:...)、(?=...)、(?!...)、[...] - 3.量词限定符
{m}、{m,n}、{m,}、?、*、+ - 4.位置和序列
^、$、\元字符、 一般字符 - 5.管道符(竖杠)
|
上面操作符的优先级从上至下,由高到低。
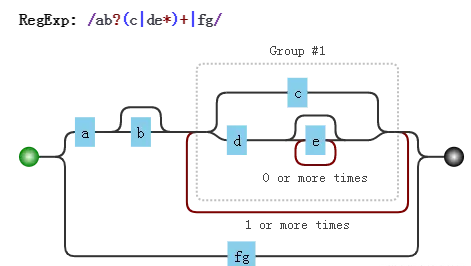
分析一个正则:
/ab?(c|de*)+|fg/
- 由于括号的存在,所以,
(c|de*)是一个整体结构。
- 由于括号的存在,所以,
- 在
(c|de*)中,注意其中的量词*,因此e*是一个整体结构。
- 在
- 又因为分支结构“|”优先级最低,因此 c 是一个整体、而
de*是另一个整体。
- 又因为分支结构“|”优先级最低,因此 c 是一个整体、而
- 同理,整个正则分成了
a、b?、(...)+、f、g。而由于分支的原因,又可以分成ab?(c|de*)+和fg这两部分。
- 同理,整个正则分成了
2. 注意要点
2.1 匹配字符串整体问题
因为是要匹配整个字符串,我们经常会在正则前后中加上锚字符^和$。
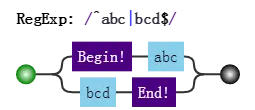
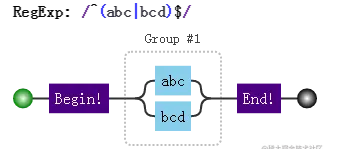
比如要匹配目标字符串"abc"或者"bcd"时,如果一不小心,就会写成/^abc|bcd$/。
而位置字符和字符序列优先级要比竖杠高,故其匹配的结构是:
应该修改成:
2.2 量词连缀问题
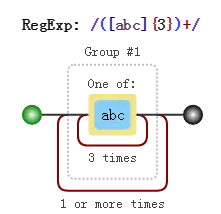
假设,要匹配这样的字符串:
- 每个字符为 a、b、c 任选其一
- 字符串的长度是 3 的倍数
此时正则不能想当然地写成/^[abc]{3}+$/,这样会报错,说+前面没什么可重复的:
此时要修改成:
2.3 元字符转义问题
所有结构里,用到的元字符总结如下:
^$.*+?|\/()[]{}=!:-,
当匹配上面的字符本身时,可以一律转义:
var string = '^$.*+?|\\/[]{}=!:-,';
var regex = /\^\$\.\*\+\?\|\\\/\[\]\{\}\=\!\:\-\,/;
console.log(regex.test(string));
// => true另外,在 string 中,也可以把每个字符转义,当然,转义后的结果仍是本身:
var string = '^$.*+?|\\/[]{}=!:-,';
var string2 = '^$.*+?|\\/[]{}=!:-,';
console.log(string == string2);
// => true2.3.1 字符组中的元字符
跟字符组相关的元字符有[]、^、-。因此在会引起歧义的地方进行转义。例如开头的^必须转义,不然会把整个字符组,看成反义字符组。
var string = '^$.*+?|\\/[]{}=!:-,';
var regex = /[\^$.*+?|\\/\[\]{}=!:\-,]/g;
console.log(string.match(regex));
// => ["^", "$", ".", "*", "+", "?", "|", "\", "/", "[", "]", "{", "}", "=", "!", ":", "-", ","]2.3.2 匹配“[abc]”和“{3,5}”
我们知道[abc],是个字符组。如果要匹配字符串"[abc]"时,该怎么办?
可以写成/\[abc\]/,也可以写成/\[abc]/,测试如下:
var string = '[abc]';
var regex = /\[abc]/g;
console.log(string.match(regex)[0]);
// => "[abc]"只需要在第一个方括号转义即可,因为后面的方括号构不成字符组,正则不会引发歧义,自然不需要转义。
同理,要匹配字符串"{3,5}",只需要把正则写成/\{3,5}/即可。
另外,我们知道量词有简写形式{m,},却没有{,n}的情况。虽然后者不构成量词的形式,但此时并不会报错。当然,匹配的字符串也是"{,n}",测试如下:
var string = '{,3}';
var regex = /{,3}/g;
console.log(string.match(regex)[0]);
// => "{,3}"2.3.3 其余情况
比如= ! : - ,等符号,只要不在特殊结构中,也不需要转义。
但是,括号需要前后都转义的,如/\(123\)/。
至于剩下的^ $ . * + ? | \ /等字符,只要不在字符组内,都需要转义的。
示例
3.1 身份证
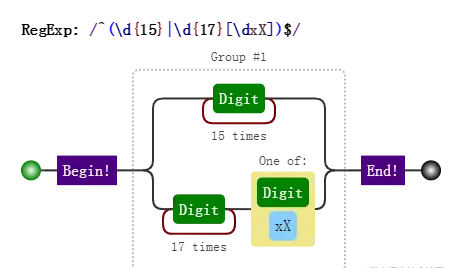
正则表达式是:
/^(\d{15}|\d{17}[\dxX])$/
因为竖杠“|”,的优先级最低,所以正则分成了两部分\d{15}和\d{17}[\dxX]。
3.2 IPV4 地址
正则表达式是:
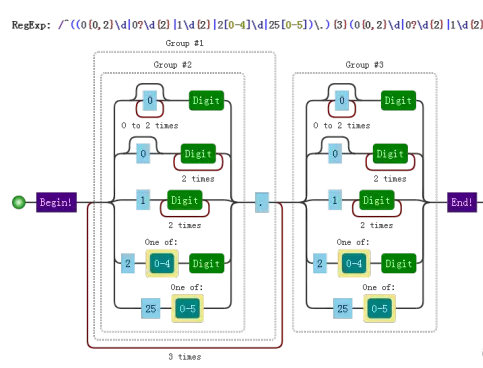
/^((0{0,2}\d|0?\d{2}|1\d{2}|2[0-4]\d|25[0-5])\.){3}(0{0,2}\d|0?\d{2}|1\d{2}|2[0-4]\d|25[0-5])$/
得出如下的结构:
((...)\.){3}(...)
上面的两个(...)是一样的结构。表示匹配的是 3 位数字。因此整个结构是
3 位数.3 位数.3 位数.3 位数
- 0{0,2}\d,匹配一位数,包括 0 补齐的。比如,9、09、009;
- 0?\d{2},匹配两位数,包括 0 补齐的,也包括一位数;
- 1\d{2},匹配 100 到 199;
- 2[0-4]\d,匹配 200-249;
- 25[0-5],匹配 250-255。
正则表达式的构建
1. 平衡法则
- 匹配预期的字符串
- 不匹配非预期的字符串
- 可读性和可维护性
- 效率
2. 构建正则前提
- 是否能使用正则; 比如匹配这样的字符串:1010010001....;虽然很有规律,但是只靠正则就是无能为力。
- 是否有必要使用正则
- 是否有必要构建一个复杂的正则;比如密码匹配问题
其实可以使用多个小正则来做:
var regex1 = /^[0-9A-Za-z]{6,12}$/;
var regex2 = /^[0-9]{6,12}$/;
var regex3 = /^[A-Z]{6,12}$/;
var regex4 = /^[a-z]{6,12}$/;
function checkPassword(string) {
  if (!regex1.test(string)) return false;
  if (regex2.test(string)) return false;
  if (regex3.test(string)) return false;
  if (regex4.test(string)) return false;
  return true;
}3. 准确性
所谓准确性,就是能匹配预期的目标,并且不匹配非预期的目标。
4. 效率
正则表达式的运行分为如下的阶段:
- 编译
- 设定起始位置
- 尝试匹配
- 匹配失败的话,从下一位开始继续第 3 步
- 最终结果:匹配成功或失败
var regex = /\d+/g;
console.log(regex.lastIndex, regex.exec('123abc34def'));
console.log(regex.lastIndex, regex.exec('123abc34def'));
console.log(regex.lastIndex, regex.exec('123abc34def'));
console.log(regex.lastIndex, regex.exec('123abc34def'));
// => 0 ["123", index: 0, input: "123abc34def"]
// => 3 ["34", index: 6, input: "123abc34def"]
// => 8 null
// => 0 ["123", index: 0, input: "123abc34def"]当尝试匹配时,需要确定从哪一位置开始匹配。一般情形都是字符串的开头,即第 0 位。
但当使用test和exec方法,且正则有g时,起始位置是从正则对象的lastIndex属性开始。
比如第一次 exec,从 0 开始,去尝试匹配,并且成功地匹配到 3 个数字。此时结束时的下标是 2,因此下一次的起始位置是 3。
而第二次,起始下标是 3,但第 3 个字符是“a”,并不是数字。但此时并不会直接报匹配失败,而是移动到下一位置,即从第 4 位开始继续尝试匹配,但该字符是 b,也不是数字。再移动到下一位,是 c 仍不行,再移动一位是数字 3,此时匹配到了两位数字 34。此时,下一次匹配的位置是 d 的位置,即第 8 位。
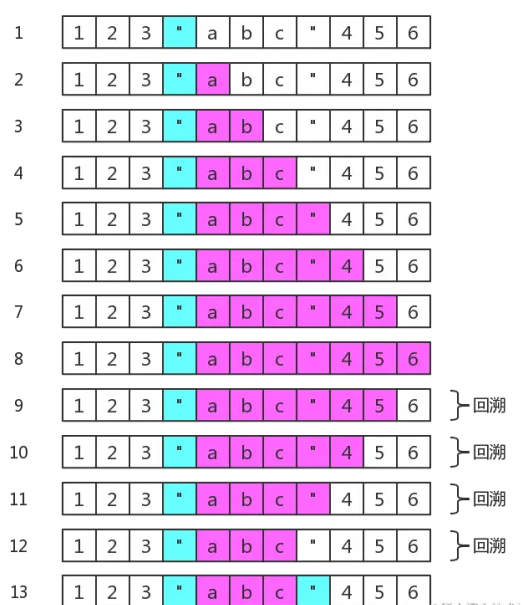
4.1 使用具体型字符组来代替通配符,来消除回溯
例如,匹配双引用号之间的字符。如,匹配字符串 123"abc"456 中的"abc"。 如果正则用的是:/".*"/,,会在第 3 阶段产生 4 次回溯(粉色表示.*匹配的内容):
 如果正则用的是:
/".*?"/,会产生 2 次回溯:
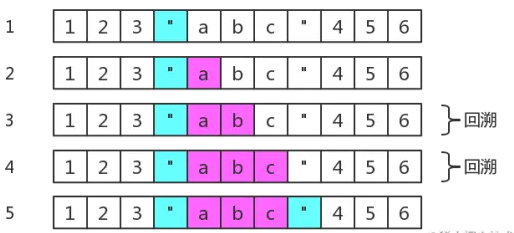
因为回溯的存在,需要引擎保存多种可能中未尝试过的状态,以便后续回溯时使用。注定要占用一定的内存。
此时要使用具体化的字符组,来代替通配符.,以便消除不必要的字符,此时使用正则/"[^"]*"/,即可
4.2 使用非捕获型分组
因为括号的作用之一是,可以捕获分组和分支里的数据。那么就需要内存来保存它们。
当我们不需要使用分组引用和反向引用时,此时可以使用非捕获分组。例如:
/^[+-]?(\d+\.\d+|\d+|\.\d+)$/
可以修改成:
/^[+-]?(?:\d+\.\d+|\d+|\.\d+)$/
4.3 独立出确定字符
例如/a+/,可以修改成/aa*/。
因为后者能比前者多确定了字符 a。这样会在第四步中,加快判断是否匹配失败,进而加快移位的速度
4.4 提取分支公共部分
比如/^abc|^def/,修改成/^(?:abc|def)/。
这样做,可以减少匹配过程中可消除的重复。
4.5 减少分支的数量,缩小它们的范围
/red|read/,可以修改成/rea?d/。此时分支和量词产生的回溯的成本是不一样的。但这样优化后,可读性会降低的。
小结
针对每种情形,分别写出正则,然用分支把他们合并在一起,再提取分支公共部分,就能得到准确的正则。
正则表达式编程
1. 正则表达式的四种操作
正则表达式是匹配模式,不管如何使用正则表达式,万变不离其宗,都需要先“匹配”。
有了匹配这一基本操作后,才有其他的操作:验证、切分、提取、替换。
1.1 验证
所谓匹配,就是看目标字符串里是否有满足匹配的子串。因此,“匹配”的本质就是“查找”。
有没有匹配,是不是匹配上,判断是否的操作,即称为“验证”。
比如,判断一个字符串中是否有数字。
使用search
var regex = /\d/;
var string = 'abc123';
console.log(!!~string.search(regex));
// => true使用test
var regex = /\d/;
var string = 'abc123';
console.log(regex.test(string));
// => true使用match
var regex = /\d/;
var string = 'abc123';
console.log(!!string.match(regex));
// => true使用exec
var regex = /\d/;
var string = 'abc123';
console.log(!!regex.exec(string));
// => true1.2 切分
所谓“切分”,就是把目标字符串,切成一段一段的。在 JS 中使用的是 split。
1.3 提取
虽然整体匹配上了,但有时需要提取部分匹配的数据。
此时正则通常要使用分组引用(分组捕获)功能,还需要配合使用相关 API。
match
var regex = /^(\d{4})\D(\d{2})\D(\d{2})$/;
var string = '2017-06-26';
console.log(string.match(regex));
// =>["2017-06-26", "2017", "06", "26", index: 0, input: "2017-06-26"]exec
var regex = /^(\d{4})\D(\d{2})\D(\d{2})$/;
var string = '2017-06-26';
console.log(regex.exec(string));
// =>["2017-06-26", "2017", "06", "26", index: 0, input: "2017-06-26"]test
var regex = /^(\d{4})\D(\d{2})\D(\d{2})$/;
var string = '2017-06-26';
regex.test(string);
console.log(RegExp.$1, RegExp.$2, RegExp.$3);
// => "2017" "06" "26"search
var regex = /^(\d{4})\D(\d{2})\D(\d{2})$/;
var string = '2017-06-26';
string.search(regex);
console.log(RegExp.$1, RegExp.$2, RegExp.$3);
// => "2017" "06" "26"replace
var regex = /^(\d{4})\D(\d{2})\D(\d{2})$/;
var string = '2017-06-26';
var date = [];
string.replace(regex, function (match, year, month, day) {
  date.push(year, month, day);
});
console.log(date);
// => ["2017", "06", "26"]1.4 替换
var string = '2017-06-26';
var today = new Date(string.replace(/-/g, '/'));
console.log(today);
// => Mon Jun 26 2017 00:00:00 GMT+0800 (中国标准时间)2. 相关 API 注意要点
2.1 test 整体匹配时需要使用^和$
2.2 使用构造函数需要注意的问题
一般不推荐使用构造函数生成正则,而应该优先使用字面量。因为用构造函数会多写很多\。
var string = '2017-06-27 2017.06.27 2017/06/27';
var regex = /\d{4}(-|\.|\/)\d{2}\1\d{2}/g;
console.log(string.match(regex));
// => ["2017-06-27", "2017.06.27", "2017/06/27"]

regex = new RegExp('\\d{4}(-|\\.|\\/)\\d{2}\\1\\d{2}', 'g');
console.log(string.match(regex));
// => ["2017-06-27", "2017.06.27", "2017/06/27"]2.3 修饰符
g全局匹配,即找到所有匹配的,单词是 globali忽略字母大小写,单词 ingoreCasem多行匹配,只影响^和$,二者变成行的概念,即行开头和行结尾。单词是 multiline
2.4 source 属性
正则实例对象属性,除了global、ingnoreCase、multiline、lastIndex属性之外,还有一个 source 属性。
可以通过查看该属性,来确认构建出的正则到底是什么:
var className = 'high';
var regex = new RegExp('(^|\\s)' + className + '(\\s|$)');
console.log(regex.source);
// => (^|\s)high(\s|$) 即字符串"(^|\\s)high(\\s|$)"2.5 构造函数属性
构造函数的静态属性基于所执行的最近一次正则操作而变化。除了是$1,...,$9之外,还有几个不太常用的属性(有兼容性问题):
RegExp.input最近一次目标字符串,简写成 RegExp["$_"]RegExp.lastMatch最近一次匹配的文本,简写成 RegExp["$&"]RegExp.lastParen最近一次捕获的文本,简写成 RegExp["$+"]RegExp.leftContext目标字符串中 lastMatch 之前的文本,简写成 RegExp["$`"]RegExp.rightContext目标字符串中 lastMatch 之后的文本,简写成 RegExp["$'"]
var regex = /([abc])(\d)/g;
var string = 'a1b2c3d4e5';
string.match(regex);

console.log(RegExp.input);
console.log(RegExp['$_']);
// => "a1b2c3d4e5"

console.log(RegExp.lastMatch);
console.log(RegExp['$&']);
// => "c3"

console.log(RegExp.lastParen);
console.log(RegExp['$+']);
// => "3"

console.log(RegExp.leftContext);
console.log(RegExp['$`']);
// => "a1b2"

console.log(RegExp.rightContext);
console.log(RegExp["$'"]);
// => "d4e5"Details
<section>
  <div id="err"></div>
  <input id="regex" placeholder="请输入正则表达式" />
  <input id="text" placeholder="请输入测试文本" />
  <button id="run">测试一下</button>
  <div id="result"></div>
</section>
<style>
  section {
    display: flex;
    flex-direction: column;
    justify-content: space-around;
    height: 300px;
    padding: 0 200px;
  }
  section * {
    min-height: 30px;
  }
  #err {
    color: red;
  }
  #result {
    line-height: 30px;
  }
  .info {
    background: #00c5ff;
    padding: 2px;
    margin: 2px;
    display: inline-block;
  }
</style>
<script>
  (function () {
    // 获取相应dom元素
    var regexInput = document.getElementById('regex');
    var textInput = document.getElementById('text');
    var runBtn = document.getElementById('run');
    var errBox = document.getElementById('err');
    var resultBox = document.getElementById('result');

    // 绑定点击事件
    runBtn.onclick = function () {
      // 清除错误和结果
      errBox.innerHTML = '';
      resultBox.innerHTML = '';

      // 获取正则和文本
      var text = textInput.value;
      var regex = regexInput.value;

      if (regex == '') {
        errBox.innerHTML = '请输入正则表达式';
      } else if (text == '') {
        errBox.innerHTML = '请输入测试文本';
      } else {
        regex = createRegex(regex);
        if (!regex) return;
        var result,
          results = [];

        // 没有修饰符g的话,会死循环
        if (regex.global) {
          while ((result = regex.exec(text))) {
            results.push(result);
          }
        } else {
          results.push(regex.exec(text));
        }

        if (results[0] == null) {
          resultBox.innerHTML = '匹配到0个结果';
          return;
        }

        // 倒序是有必要的
        for (var i = results.length - 1; i >= 0; i--) {
          var result = results[i];
          var match = result[0];
          var prefix = text.substr(0, result.index);
          var suffix = text.substr(result.index + match.length);
          text =
            prefix + '<span class="info">' + match + '</span>' + suffix;
        }
        resultBox.innerHTML =
          '匹配到' + results.length + '个结果:<br>' + text;
      }
    };

    // 生成正则表达式,核心函数
    function createRegex(regex) {
      try {
        if (regex[0] == '/') {
          regex = regex.split('/');
          regex.shift();
          var flags = regex.pop();
          regex = regex.join('/');
          regex = new RegExp(regex, flags);
        } else {
          regex = new RegExp(regex, 'g');
        }
        return regex;
      } catch (e) {
        errBox.innerHTML = '无效的正则表达式';
        return false;
      }
    }
  })();
</script>